Visão Estereoscópica: Criando Profundidade 3D para Robôs sem LiDAR
Para que um robô navegue pelo mundo de forma autônoma, ele precisa de algo que nós, humanos, consideramos garantido: a percepção de profundidade. Saber se um obstáculo está perto ou longe, se um objeto pode ser alcançado ou se um corredor é seguro para atravessar é fundamental. Tradicionalmente, sensores caros como o LiDAR têm dominado essa área. No entanto, uma alternativa elegante e eficiente, inspirada na própria biologia, está transformando a robótica autônoma: a Visão Estereoscópica.
Essa tecnologia utiliza um par de câmeras, funcionando como um par de olhos, para calcular a distância e criar um mapa tridimensional do ambiente. Ao analisar as pequenas diferenças entre as imagens capturadas, os robôs podem “ver” em 3D, ganhando uma compreensão espacial rica e detalhada. Este artigo desvenda como a visão estereoscópica funciona, suas vantagens sobre outras tecnologias, os desafios que enfrenta e suas aplicações práticas que estão moldando o futuro da interação robô-ambiente.
A Percepção Robótica e a Necessidade de Profundidade 3D
A capacidade de um robô interagir com o mundo de forma inteligente depende diretamente de seus sistemas de percepção. Sem uma compreensão precisa do ambiente, uma máquina é essencialmente cega, limitada a tarefas pré-programadas em cenários controlados. É aqui que a percepção espacial se torna a base para qualquer nível de autonomia.
O Papel Essencial da Percepção Espacial
A percepção espacial não é apenas sobre ver, mas sobre entender as relações entre os objetos e o próprio robô. Ela responde a perguntas críticas para a navegação robótica:
- A que distância está a parede à frente?
- Qual o tamanho daquele objeto na mesa?
- Existe um degrau ou um buraco no caminho?
Sem a terceira dimensão — a profundidade —, um robô enxerga o mundo como uma fotografia plana. Uma cadeira distante pode parecer do mesmo tamanho que uma caixa próxima. Essa ambiguidade torna tarefas simples, como desviar de obstáculos ou pegar um item, extremamente complexas e propensas a falhas. A percepção de profundidade transforma essa imagem plana em um modelo 3D funcional, permitindo que a inteligência artificial do robô tome decisões informadas.
Desafios na Navegação e Interação Autônoma
Em ambientes dinâmicos, onde pessoas se movem e objetos mudam de lugar, os desafios se multiplicam. Um robô de logística em um armazém ou um veículo autônomo em uma rua precisa constantemente reavaliar seu entorno. A ausência de dados 3D confiáveis leva a paradas constantes, colisões ou a incapacidade de completar tarefas. A interação física, como a manipulação de objetos por um braço robótico, exige uma precisão milimétrica que só a percepção 3D pode fornecer. Portanto, equipar robôs com uma forma robusta de “ver” em três dimensões não é um luxo, mas uma necessidade fundamental para sua funcionalidade e segurança.
Visão Estereoscópica: Um Olhar Inspirado na Natureza
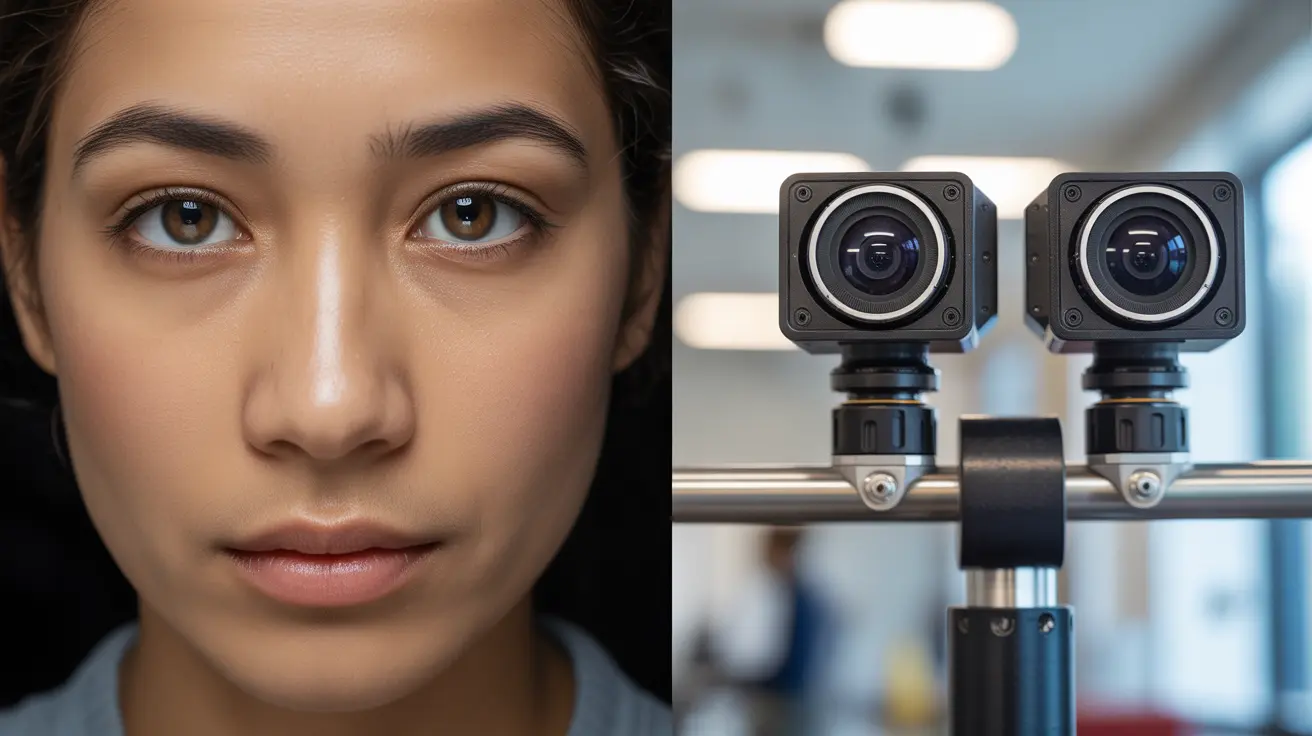
A solução para um dos maiores desafios da robótica estava, o tempo todo, bem na nossa frente. A Visão Estereoscópica é um exemplo clássico de biomimética, a engenharia que busca inspiração em sistemas biológicos. Ela replica o princípio fundamental que permite a humanos e a muitos outros animais perceberem a profundidade com tanta naturalidade.
O Princípio Biológico da Visão Estéreo
Nossos olhos estão separados por uma pequena distância horizontal. Por causa disso, cada olho captura uma imagem ligeiramente diferente do mesmo cenário. Você pode testar isso facilmente: estique o braço com o polegar para cima e olhe para ele, alternando entre fechar o olho esquerdo e o direito. Você notará que o seu polegar parece “saltar” em relação ao fundo.
Essa diferença, conhecida como paralaxe ou disparidade, é processada pelo nosso cérebro. Ele funde as duas imagens e usa o grau de disparidade para calcular a distância. Objetos mais próximos apresentam uma disparidade maior (parecem se mover mais), enquanto objetos distantes têm uma disparidade menor. É esse processo neural que nos dá uma rica e instantânea percepção de profundidade.
Como Duas Câmeras Simulam a Visão Humana
Os sistemas de visão computacional replicam esse processo com notável precisão. Em vez de olhos, eles usam um par de câmeras estéreo, montadas em uma barra com uma distância fixa e conhecida entre elas (a “linha de base”). Ambas as câmeras são sincronizadas para capturar imagens exatamente no mesmo instante.
O “cérebro” do sistema é um algoritmo de processamento de imagem que:
1. Identifica os mesmos pontos de interesse (como cantos, texturas ou bordas) em ambas as imagens.
2. Mede a diferença na posição horizontal desses pontos correspondentes.
3. Calcula a disparidade para cada ponto da imagem.
Com base nessa disparidade e na geometria conhecida do sistema de câmeras, a distância de cada ponto pode ser calculada por meio de triangulação, gerando um mapa de profundidade detalhado do ambiente.
O Funcionamento Detalhado dos Sistemas de Visão Estereoscópica
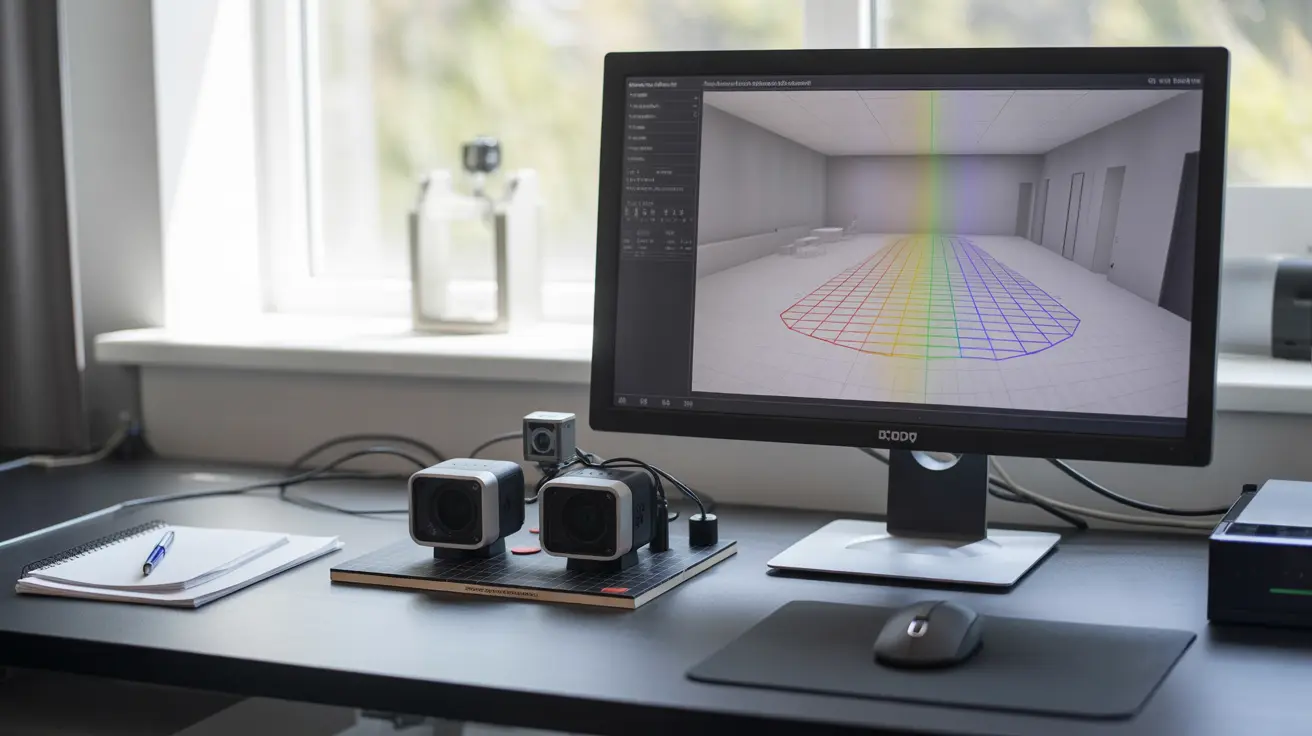
Transformar duas imagens 2D em um mapa 3D coeso é um processo computacionalmente sofisticado, dividido em etapas claras e sequenciais. Cada fase é crucial para garantir a precisão dos dados de profundidade, que servirão de base para as decisões do robô.
Captura de Imagens e Calibração das Câmeras
Tudo começa com a captura simultânea de duas imagens por um par de câmeras. Para que o sistema funcione, ele precisa conhecer com extrema precisão a sua própria geometria. Esse processo é chamado de calibração. Durante a calibração, são determinados:
- Parâmetros intrínsecos: Distância focal, ponto principal e distorção da lente de cada câmera.
- Parâmetros extrínsecos: A posição e a orientação exatas de uma câmera em relação à outra (rotação e translação).
Sem uma calibração precisa, os cálculos de profundidade seriam repletos de erros, tornando a reconstrução 3D inútil.
O Processo de Correspondência de Pontos
Esta é a etapa mais desafiadora do processamento de imagem. O algoritmo precisa encontrar o mesmo ponto físico do mundo real nas duas imagens. Ele percorre a imagem da esquerda, pixel por pixel (ou em blocos de pixels), e busca por sua contraparte correspondente na imagem da direita. Para encontrar a correspondência, os algoritmos analisam características como cor, brilho e textura ao redor do pixel.
Gerando Mapas de Disparidade e Profundidade
Uma vez que os pontos correspondentes são encontrados, o sistema calcula a disparidade: a diferença em colunas (coordenada x) entre a posição do ponto na imagem esquerda e na direita. Pontos que estão mais próximos da câmera terão uma disparidade maior, enquanto pontos distantes terão uma disparidade pequena ou quase nula. O resultado é um mapa de disparidade, uma imagem em escala de cinza (ou colorida para visualização) onde a intensidade de cada pixel representa a disparidade naquele ponto. A partir deste mapa, uma fórmula matemática simples converte os valores de disparidade em valores de profundidade (distância em metros).
| Etapa do Processo | Objetivo Principal | Informação Gerada |
|---|---|---|
| — | — | — |
| Calibração | Conhecer a geometria do sistema de câmeras | Parâmetros intrínsecos e extrínsecos |
| Correspondência | Encontrar os mesmos pontos nas duas imagens | Pares de pontos correspondentes |
| Cálculo de Disparidade | Medir a diferença de posição dos pontos | Mapa de disparidade |
| Cálculo de Profundidade | Converter disparidade em distância real | Mapa de profundidade ou nuvem de pontos 3D |
A Reconstrução 3D do Ambiente
Com o mapa de profundidade em mãos, o robô agora tem as coordenadas (X, Y, Z) de inúmeros pontos na cena. Esse conjunto de dados é conhecido como “nuvem de pontos” e representa a estrutura tridimensional do ambiente. Essa nuvem de pontos pode ser usada diretamente para navegação e detecção de obstáculos ou processada para criar modelos 3D mais complexos da cena.
Perguntas Frequentes
Qual a principal diferença entre visão estereoscópica e LiDAR?
A visão estereoscópica é uma tecnologia passiva que usa duas câmeras para calcular a profundidade através do processamento de imagem, semelhante à visão humana. O LiDAR, por sua vez, é um sensor ativo que emite pulsos de laser e mede o tempo que a luz leva para retornar, calculando a distância diretamente.
O que é um mapa de disparidade?
Um mapa de disparidade é uma representação visual onde o valor de cada pixel corresponde à diferença de posição horizontal de um ponto entre a imagem esquerda e a direita de um par estéreo. Objetos mais próximos têm maior disparidade (valores mais altos), permitindo a posterior conversão para um mapa de profundidade.
Visão estereoscópica funciona no escuro?
Não, por ser uma tecnologia passiva baseada em câmeras convencionais, a visão estereoscópica depende da iluminação ambiente para funcionar. No escuro total, as câmeras não conseguem capturar detalhes, impossibilitando o processo de correspondência de pontos. No entanto, ela pode ser combinada com iluminadores infravermelhos para operar em condições de baixa luminosidade.
Por que superfícies sem textura são um problema?
Superfícies uniformes, como uma parede branca ou um piso polido, não possuem características visuais distintas. Isso dificulta ou impossibilita que os algoritmos encontrem pontos correspondentes entre as duas imagens, criando “buracos” ou áreas sem dados de profundidade no mapa 3D final.
A visão estereoscópica é computacionalmente cara?
Sim, o processo de correspondência de pontos, que envolve comparar grandes regiões de duas imagens para encontrar milhares de correspondências, exige um poder de processamento significativo. Frequentemente, são utilizadas GPUs (Unidades de Processamento Gráfico) para acelerar esses cálculos e permitir a operação em tempo real, essencial para robôs móveis.
Qual a principal vantagem de usar visão estéreo em robôs?
A principal vantagem é a combinação de baixo custo e riqueza de dados. Câmeras são componentes baratos e amplamente disponíveis. Além de fornecer dados de profundidade 3D, a visão estéreo também captura informações de cor e textura, o que é crucial para tarefas de reconhecimento de objetos e classificação de cenas.
O que é triangulação em visão computacional?
Triangulação é o método geométrico usado para determinar a posição 3D de um ponto no espaço. Conhecendo a posição exata das duas câmeras (a linha de base) e os ângulos sob os quais cada câmera vê o ponto (derivados da sua posição nos sensores de imagem), é possível calcular a intersecção das linhas de visão e encontrar sua coordenada Z (profundidade).